AI 크롤러 차단과 인용 노출 설계
2026년 11월 11일
💡 바쁜 분들을 위한 3줄 요약
①robots.txt는 학습용 봇과 검색·인용용 봇을 이름별로 구분해 관리해야 합니다.
② 공식 표준으로 확인되지 않은 ‘AIPREF’ 메타 태그만으로 학습 거부 또는 인용 보장을 기대해서는 안 됩니다.
③ 공개 페이지는 허용 여부·로그·실제 인용을 함께 검증하고, 민감 정보는 인증과 서버 정책으로 보호해야 합니다.
robots.txt AI 제어와 AI 검색 노출의 관계
기업의 콘텐츠 공개 정책은 단순 차단이 아니라 검색 인덱싱·실시간 웹 조회·모델 학습을 구분하는 일입니다. 다만 robots.txt는 자발적 크롤러 지침이지 접근 통제 장치가 아닙니다. 비공개 데이터는 인증, 권한 관리, 응답 제한을 병행해야 합니다. 또한 봇 이름과 준수 방식은 제공사 문서에 따라 바뀔 수 있으므로 배포 전 최신 정책을 확인해야 합니다.
목차
1. AI 크롤러 분류와 User-Agent 파편화
학습 수집과 실시간 조회는 목적이 다릅니다
일부 제공사는 학습 목적 수집과 사용자 요청에 따른 웹 조회를 별도 사용자 에이전트로 표시합니다. 예를 들어 GPTBot은 OpenAI가 학습 관련 수집에 사용하는 토큰이며, ChatGPT-User는 사용자의 명시적 웹 조회와 연결될 수 있습니다. 따라서 학습을 제한하려는 정책이 검색 답변의 출처 노출까지 반드시 차단한다는 뜻은 아닙니다. 반대로 특정 봇 허용만으로 인용이 보장되지는 않습니다.
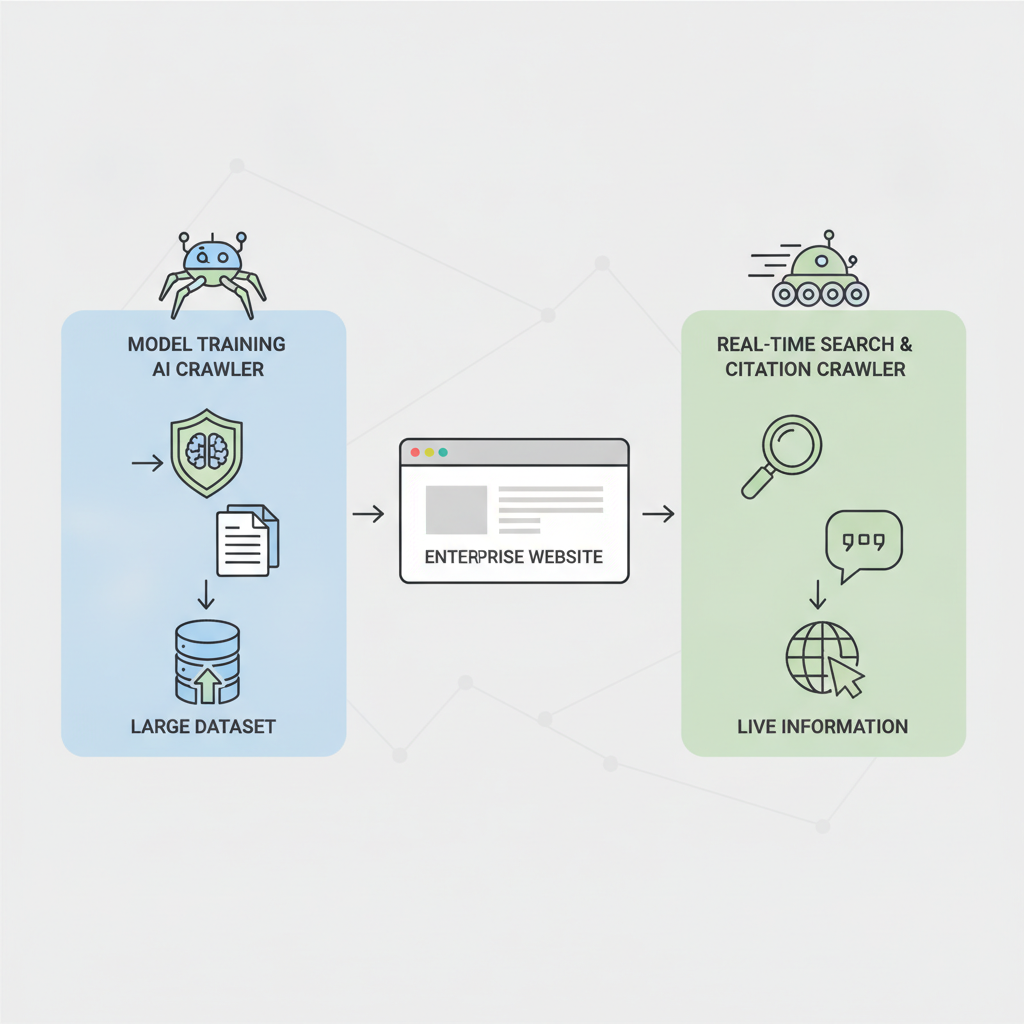
대표 AI 크롤러와 차단 영향
아래 표는 공개 문서에서 확인 가능한 역할을 중심으로 정리한 운영 참고표입니다. 실제 인용·색인 결과는 품질, 색인 상태, 서비스별 정책에 따라 달라집니다.
| AI 제공사 | 수집 에이전트 | 주요 역할 및 목적 | Disallow 시 유의점 |
|---|---|---|---|
| OpenAI | GPTBot | 모델 학습 관련 수집 | 향후 학습 수집 제외 요청으로 해석될 수 있음 |
ChatGPT-User | 사용자 요청 기반 웹 조회 | 해당 요청에서 URL 조회가 제한될 수 있음 | |
Google-Extended | Gemini 학습·개선 관련 제어 | 일반 검색 색인과 별도 토큰 | |
Googlebot | 구글 웹 검색 수집 | 차단 시 자연 검색 및 AI 개요 후보성에 영향 가능 | |
| Anthropic | ClaudeBot | Claude 관련 수집 | 공식 문서에서 최신 역할 확인 필요 |
Claude-SearchBot | 검색 기능 관련 수집 | 차단 시 검색용 접근이 제한될 수 있음 | |
| Perplexity | PerplexityBot | 검색·답변 인덱스 관련 수집 | 답변 후보 출처 접근에 영향 가능 |
2. AIPREF 주장과 한국 포털 호환성 검증
메타 태그를 표준처럼 전제하면 안 됩니다
초안의 AIPREF, ai-preference, X-AIPREF-Policy는 2026년 11월 기준 주요 검색 엔진의 공통 공식 표준으로 확인하기 어렵습니다. 따라서 아래와 같은 예시는 가상의 정책 표현일 뿐, 실제 크롤러가 해석하거나 학습 거부를 보장하는 배포 규격으로 사용해서는 안 됩니다.
<meta name="ai-preference" content="search-rag=allow, training=deny" />
X-AIPREF-Policy: rag=allow; train=disallow
운영 정책은 제공사가 문서화한 robots.txt 사용자 에이전트, 검색 색인 제어, 인증·응답 헤더를 기준으로 설계해야 합니다. 출처 신호와 채널별 수집 경로의 차이는 네이버·구글 AI 출처 신호 분리 설계 방법에서 별도로 확인할 수 있습니다.
네이버와 구글은 분리해 점검합니다
네이버 웹 검색과 AI 브리핑의 구체적 수집·인용 로직은 모두 공개되어 있지 않으므로, Yeti 차단이 어떤 영역에 미치는지를 실제 수집 현황과 노출 결과로 확인해야 합니다. 구글은 Google-Extended와 Googlebot을 구분해 안내하므로, 일반 검색 노출을 유지하려면 후자의 차단 여부를 특히 점검해야 합니다.
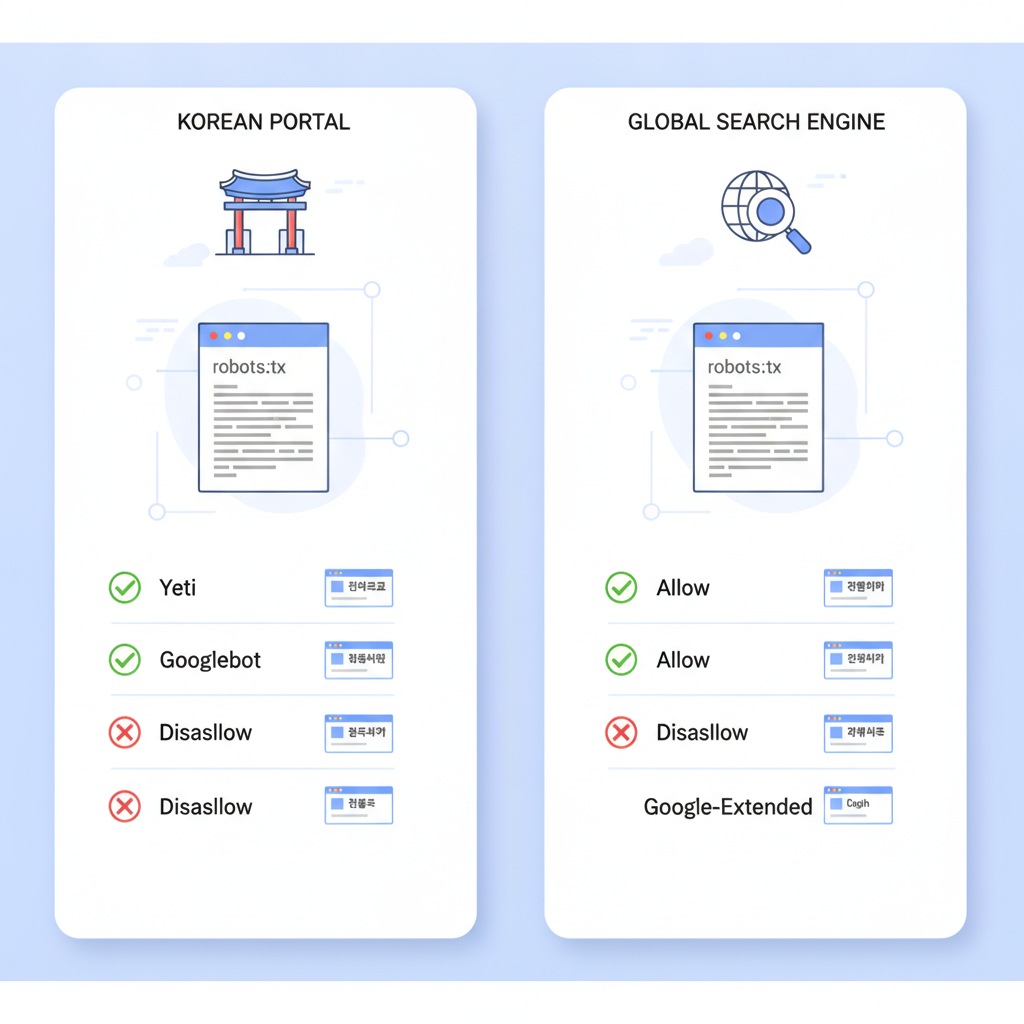
3. AI 전면 차단 정책의 역효과
User-agent: *와 Disallow: /를 적용하면 검색 엔진 접근까지 폭넓게 제한될 수 있습니다. 공식 제품 사양, 가격, 정책 문서가 수집되지 않으면 AI 답변은 제3자 문서에 의존할 가능성이 커집니다. 이는 잘못된 정보가 생성될 위험을 높일 수 있으나, 인과관계와 노출 손실은 도메인별로 측정해야 합니다.
권장 접근은 선택적 허용입니다. /blog/, /product/, /faq/처럼 공개 의도가 분명한 페이지와 /api/, /private/, /premium-reports/처럼 보호해야 할 경로를 분리합니다. 엔티티 정보의 구조화는 구글 AI 개요용 엔티티 정보구조 설계를 참고하되, 크롤러 허용과 인용 성과를 같은 지표로 혼동하지 않아야 합니다.
4. 한국 기업 실무자를 위한 4단계 아키텍처
- 자산 등급화: 공개 마케팅 자산(Tier 1), 독자 리서치(Tier 2), 개인정보·내부 자산(Tier 3)으로 URL을 분류합니다.
- 정책 적용: Tier 1은 검색 수집을 유지하고, Tier 2는 제공사별 학습 봇 제어 가능 여부를 검토합니다. Tier 3은
robots.txt뿐 아니라 로그인, 403, 접근 제어를 적용합니다. - 구현 검토: 사용자 에이전트별 규칙은 중복·상충 여부를 확인합니다. 다음 예시는 방향을 보여 주며, 서비스별 공식 문서 검증 후 적용합니다.
- 실측: 접근 로그의 사용자 에이전트·응답 코드·빈도와 실제 검색 인용을 월별로 비교합니다.
User-agent: Googlebot
User-agent: Yeti
User-agent: ChatGPT-User
Allow: /

User-agent: GPTBot
User-agent: Google-Extended
Disallow: /research-data/
Disallow: /pdf-downloads/
특히 Crawl-delay는 모든 크롤러가 지원하지 않습니다. 서버 부하는 CDN·WAF의 요청 제한, 캐시, 봇 검증으로 관리하고 정상 봇을 임의로 차단하지 않도록 로그를 함께 검토합니다.
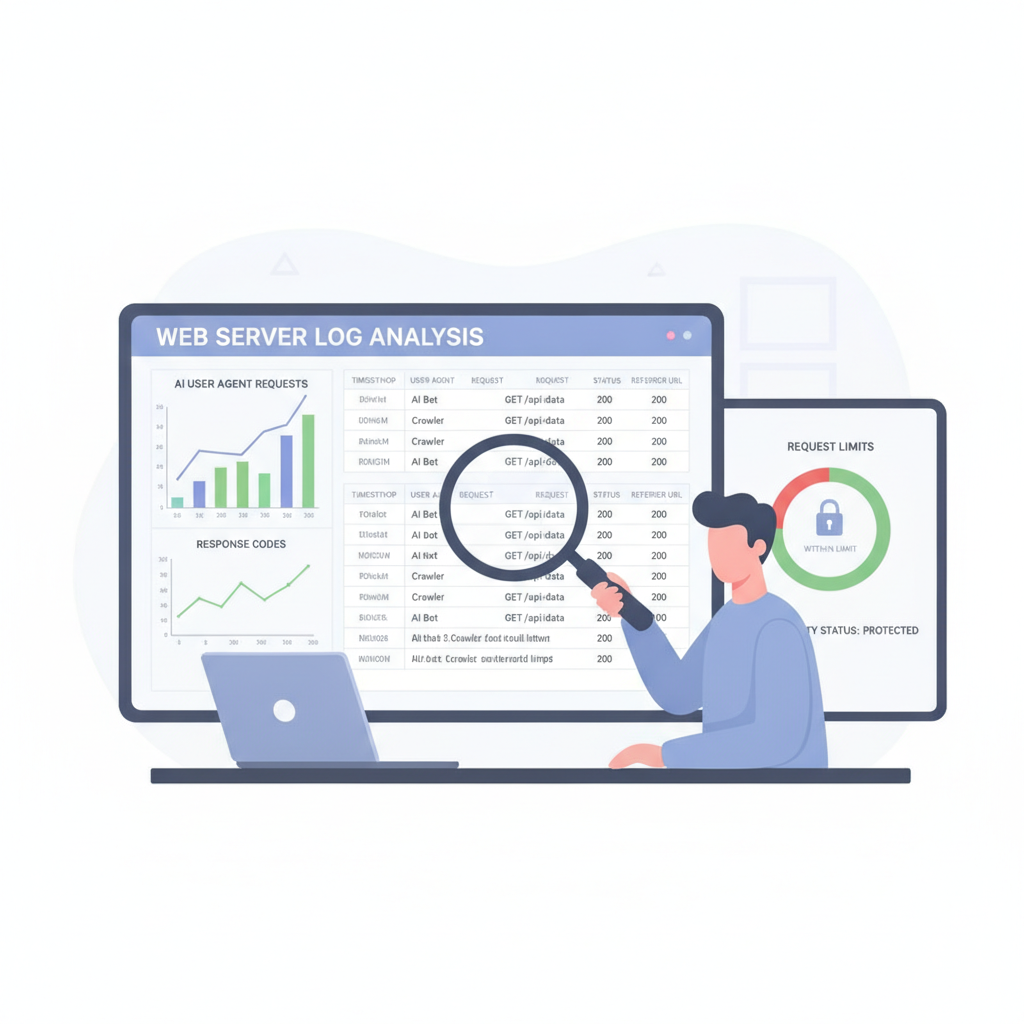
5. 실무 검증 체크리스트
| 검증 항목 | 점검 세부 내용 | 조치 방안 |
|---|---|---|
| 학습·조회 분리 | GPTBot과 조회용 봇을 개별 관리하는가? | 공식 문서 기준으로 토큰별 규칙 검토 |
| 구글 연동 | Google-Extended와 Googlebot을 혼동하지 않는가? | 일반 검색 정책을 별도 확인 |
| 비표준 신호 | 비공식 메타 태그에 의존하는가? | 제공사 공식 제어 수단으로 대체 |
| Yeti 접근 | 수집 오류와 차단 규칙이 있는가? | 서치어드바이저·서버 로그 확인 |
| 인용 유효성 | 답변에 공식 URL이 나타나는가? | 대표 질의·날짜·출처를 기록해 추적 |
자주 묻는 질문
GPTBot을 차단하면 ChatGPT 검색에서도 사라지나요?
반드시 그렇지는 않습니다. 두 사용자 에이전트의 목적이 다를 수 있으므로 각 봇의 최신 공식 문서와 실제 접근 로그를 확인해야 합니다. 다만 허용이 인용을 보장하지는 않습니다.
AIPREF 태그를 적용하면 모든 AI 기업이 따라야 하나요?
아닙니다. 공통 공식 표준으로 검증되지 않은 태그는 준수를 기대할 근거가 부족합니다. 민감 콘텐츠는 인증, 접근 제어, WAF와 제공사별 공식 봇 정책을 사용해야 합니다.
AI 크롤러가 서버 부하를 유발하면 어떻게 하나요?
접근 로그로 봇 신원을 검증한 뒤 CDN 캐시, 요청 제한, 서버 용량 정책을 적용합니다. robots.txt의 지연 지시문은 지원 여부가 제각각이므로 단독 대책으로 사용하지 않습니다.
B2B 기업은 어떤 페이지를 열어야 하나요?
제품 소개, 공개 FAQ, 고객 사례처럼 정확한 공식 설명이 필요한 페이지는 공개 목적과 보안 검토 후 수집 가능 상태를 유지합니다. 계약 자료, 개인 정보, 유료 데이터는 인증으로 보호합니다.
요약 및 실행 가이드
핵심은 ‘학습 차단’과 ‘검색 노출’을 같은 스위치로 다루지 않는 것입니다. 먼저 URL 자산을 등급화하고, 제공사별 공식 사용자 에이전트 정책을 적용한 뒤, 로그·색인·인용을 함께 관찰하십시오. AI 검색에서 브랜드 누락과 KPI의 관계를 점검하려면 AI 검색 브랜드 누락과 AEO KPI 진단 방법도 유용합니다.
현재 도메인의 크롤러 접근 상태와 생성형 AI 내 출처 노출을 비교하려면 6대 생성형 AI 무료 노출 진단으로 점검 항목을 확인할 수 있습니다. 보다 기술적인 멀티 LLM 대응 원칙은 공식 기술 백서를 참고하십시오.
참고자료
- OpenAI, GPTBot 및 사용자 요청 기반 웹 조회 관련 공식 문서.
- Google Search Central, Google-Extended 및 Googlebot 크롤링 제어 문서.
- Anthropic, 웹 크롤러 사용자 에이전트 및 robots.txt 정책 문서.
- 네이버 서치어드바이저, Yeti 수집 및 웹문서 노출 안내.
✍️ 작성 및 검수: 아지오젠(AgeoGen) 마케팅 전략팀
최종 업데이트 기준: 2026. 11. 11.
#robots.txt #AI크롤러 #AEO #GEO #GPTBot #GoogleExtended #AI검색인용 #콘텐츠보안 #Yeti #검색최적화